Airflow로 돌리는 야간 데이터 리프레시
앞선 세 편은 데이터가 이미 DB에 있다고 가정했다. 정규화되어 있고, 임베딩되어 있고, 분류되어 있고, 어제 것이 아니라고. 이 편은 그 가정을 매일 밤 참으로 만드는 파이프라인 — 그리고 PoC 예산(홈 서버 한 대, 무료 티어, 개발 계정 쿼터) 안에서 그걸 운영하며 실제로 깨진 것들 — 에 대한 이야기다.
배치가 아니면 안 되는 이유
Chapter 1의 제약을 다시 꺼내면 답은 정해져 있다.
- data.go.kr 개발 계정은 1일 1,000건이다. 사용자 요청마다 원본을 호출하면 데모 한 번에 소진된다.
- 임베딩은 과금된다. 같은 텍스트를 두 번 임베딩하는 건 돈을 두 번 내는 것이다.
- 카테고리 분류는 결정론적이어야 한다. 요청 시점에 계산하면 프로토타입 한 글자 수정이 라이브 결과를 흔든다.
그래서 런타임은 절대 원본을 호출하지 않는다. 야간 배치가 수집·정규화·임베딩·분류·적재를 끝내고, 런타임은 그 결과만 읽는다.
처음에는 다섯 단계를 순서대로 돌리는 셸 스크립트 하나였다. 충분하지 않았던 이유는 셋이다. 실패했을 때 어디서 멈췄는지 알 수 없었고, 재시도 정책이 단계마다 달라야 했고(원본 호출은 아껴야 하고, 임베딩은 펜스 덕에 마음껏 다시 돌려도 된다), 어젯밤 무슨 일이 있었는지 아침에 한눈에 보고 싶었다. 이건 정확히 워크플로 오케스트레이터가 푸는 문제고, Airflow는 그중 가장 지루하고 검증된 선택이다.
DAG: 로직은 레포에 하나만 있다
collect_courses → sync_snapshot → enrich_semantics → activate_categories → trigger_vercel_deploy
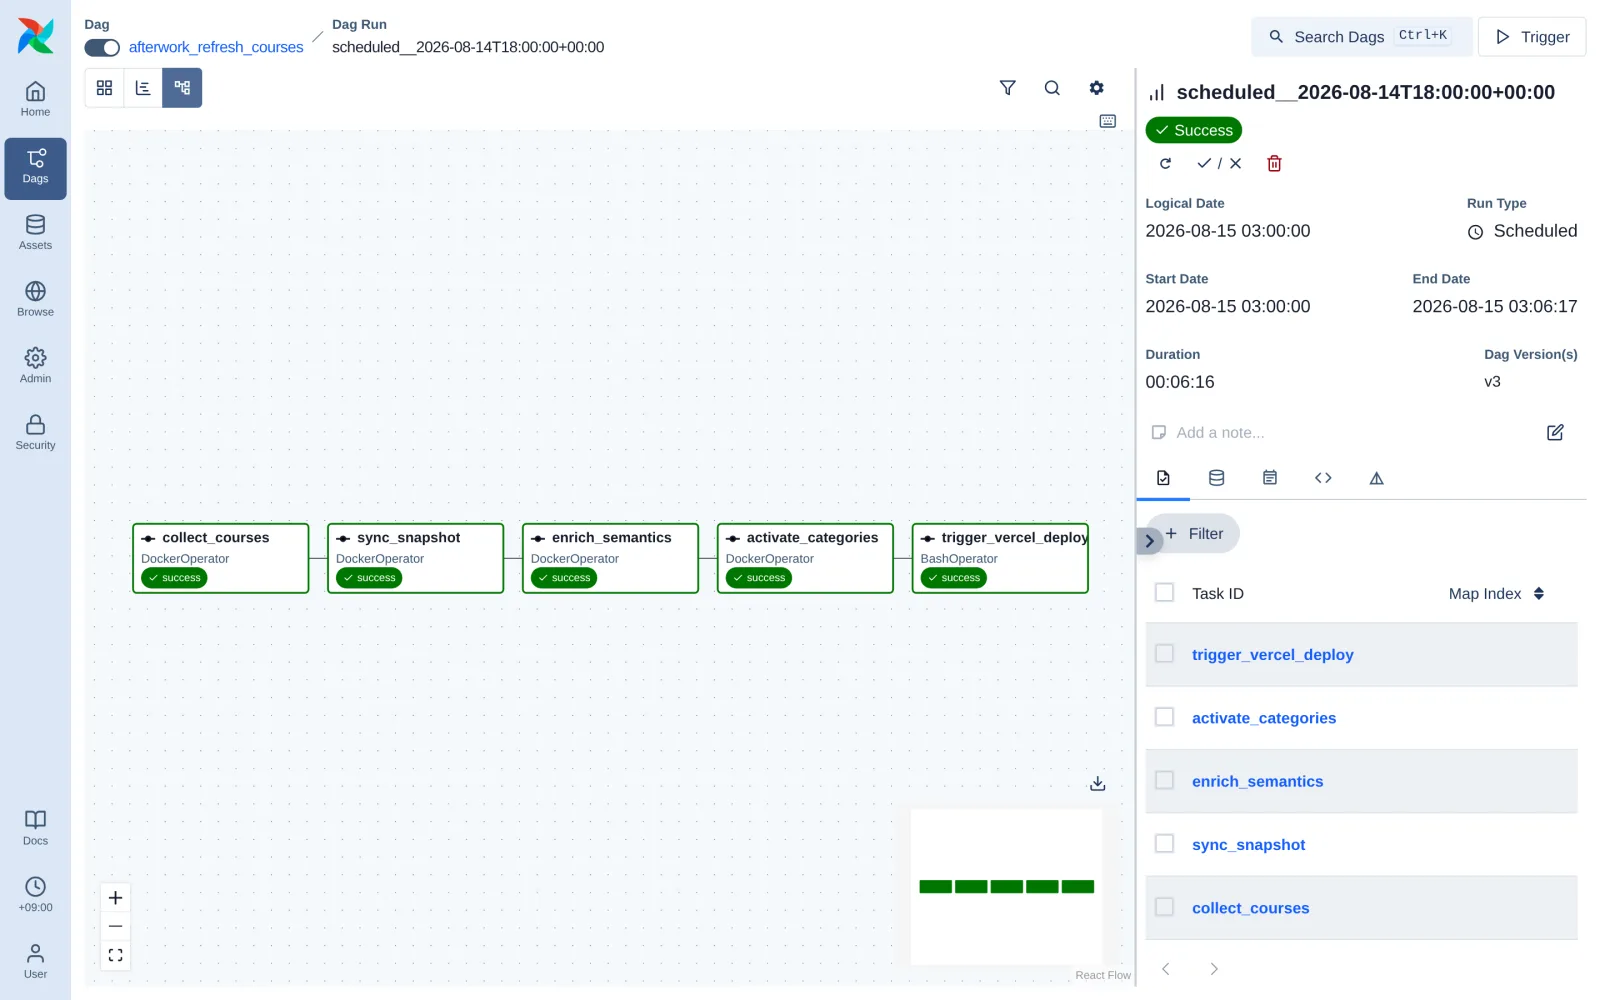
| 태스크 | 하는 일 | 원본 호출 | 재시도 |
|---|---|---|---|
collect_courses | 공공 소스에서 페이지 단위 수집, 카카오 지오코딩, 스냅샷 JSON 기록 | 있음 (쿼터 소모) | 1회, 30분 간격 |
sync_snapshot | 스냅샷 파일 → Neon courses 테이블 upsert | 없음 | 2회, 5분 |
enrich_semantics | Chapter 2의 임베딩 pass. 캐시 조회 → miss만 Upstage 호출 | Upstage (캐시 miss만) | 2회, 5분 |
activate_categories | Chapter 2의 argmax 분류, 배치 write-back | 없음 | 2회, 5분 |
trigger_vercel_deploy | Vercel Deploy Hook POST | 없음 | 2회, 5분 |
DAG 파일 자체는 짧고, 핵심은 태스크가 레포의 도구 이미지 안에서 돈다는 점이다. Airflow는 Python 로직을 실행하지 않는다. npm run collect:courses를 실행한다. 로컬 개발, Docker Compose, GitHub Actions 폴백, Airflow — 넷이 정확히 같은 스크립트와 같은 lockfile을 돌린다.
왜 이렇게까지 하는가. Airflow DAG에 비즈니스 로직을 옮겨 적기 시작하는 순간 두 벌이 생기고, 그 둘은 반드시 갈라진다. Airflow는 순서·재시도·관측성만 소유하고, 로직은 레포에 하나만 있다.
재시도 정책이 태스크마다 다른 이유
이 DAG에서 가장 의도적인 부분이 재시도 정책의 비대칭이다.
collect_courses가 실패하면 하루 쿼터의 상당 부분이 이미 나갔을 수 있다. 여기서 공격적으로 재시도하면 같은 실패를 반복하며 남은 예산까지 태운다. 그래서 딱 한 번, 30분 뒤에만. 원본 호출은 쿼터가 있는 희소 자원이고, 재시도는 그걸 아끼는 방향으로 설계한다.
반면 enrich_semantics는 Chapter 2의 캐시와 해시 펜스가 멱등성을 보장한다. 절반쯤 하다 죽어도 다시 돌리면 이미 커밋된 강좌는 캐시 hit, 안 된 것만 miss다. 재시도가 공짜에 가까우니 자유롭게 준다. 멱등성은 오케스트레이터가 주는 게 아니라 태스크가 가져야 한다 — 그래야 “그냥 다시 돌려”가 안전한 명령이 된다.
max_active_runs=1과 4시간 타임아웃은 어젯밤 run이 멈춘 채로 오늘 밤 run과 겹쳐 쿼터를 두 배로 쓰는 일을 막는다.
사건: KSPO 26,347 → 0
이 글의 스크린샷은 전부 실제 홈 서버 인스턴스에서 찍었다. 첫 주의 run 히스토리는 이렇다.
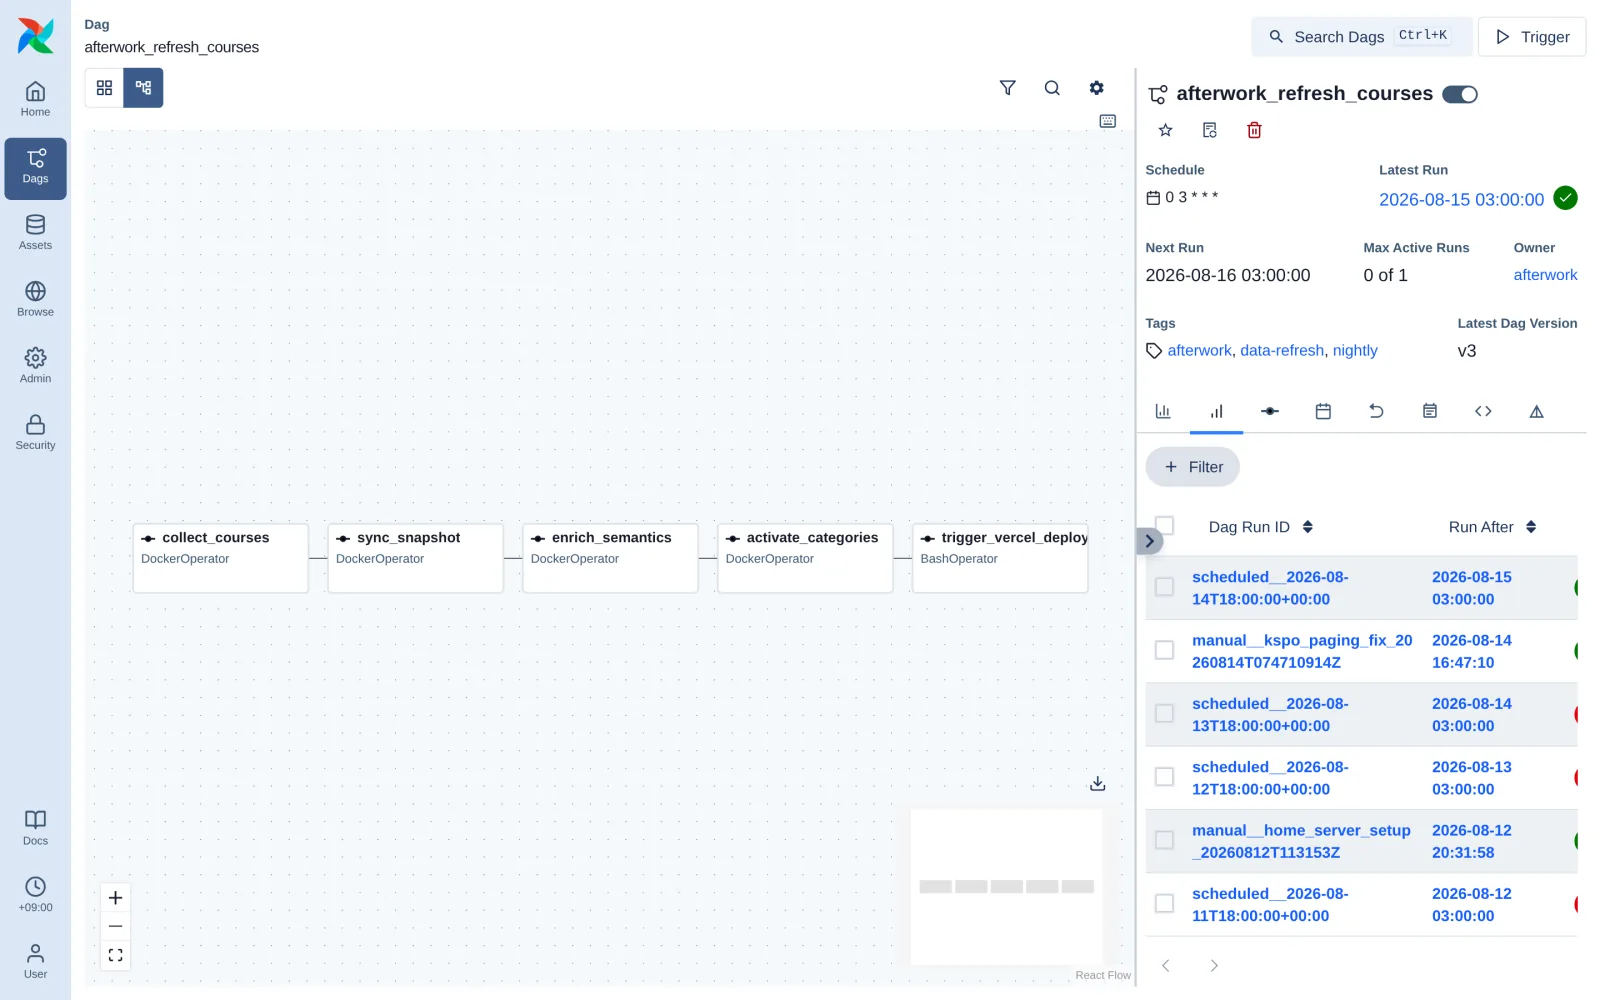
8월 13일과 14일 새벽, collect_courses가 두 번 다 재시도까지 실패했다. 태스크 로그를 열어 보면 문제가 어디서 났는지보다 왜 스냅샷이 망가지지 않았는지가 먼저 보인다.
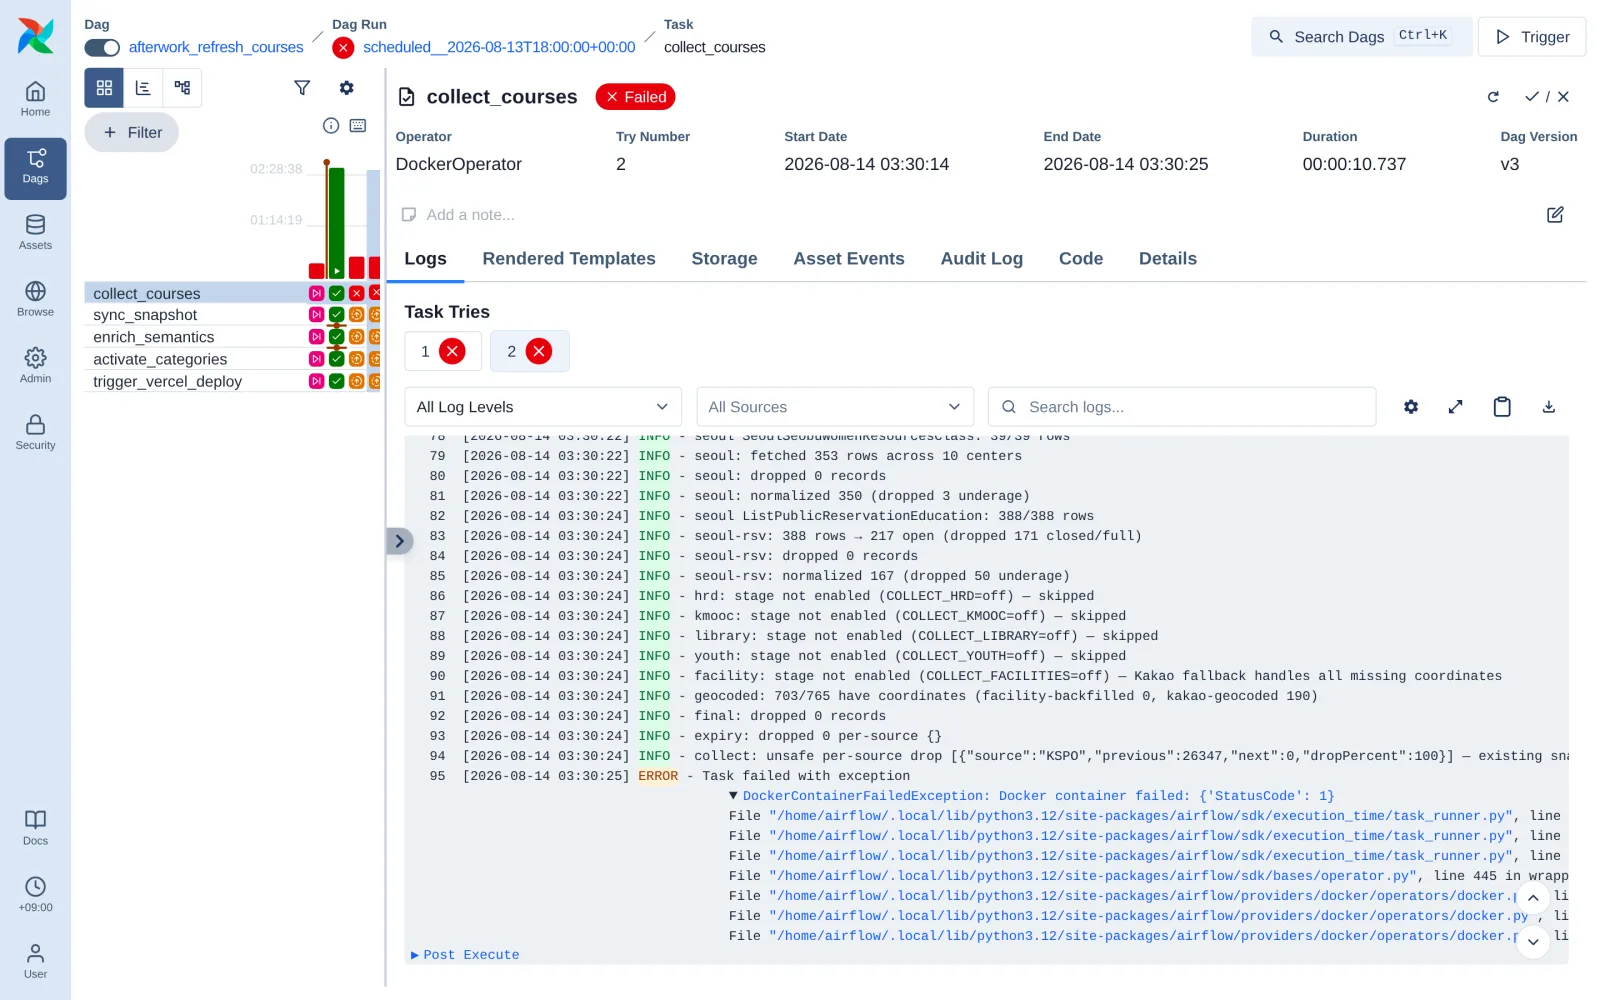
수집기는 이전 스냅샷의 소스별 건수를 기억하고, 새 수집이 어떤 소스를 60% 넘게 줄이면 새 스냅샷을 쓰지 않고 실패한다.
export function findUnsafeSourceDrops(previous, next, options = {}): SourceDrop[] {
  const minimumBaseline = options.minimumBaseline ?? 100;
  const maximumDropPercent = options.maximumDropPercent ?? 60;
  // 소스별로 이전 대비 급감을 감지하면 스냅샷을 보존한 채 실패
}
이 가드가 없었다면 그날 밤 KSPO 26,347건이 조용히 0건이 되고, sync_snapshot이 그걸 Neon에 충실히 반영하고, 아침에 운동 카테고리 게스트는 빈 지도를 봤을 것이다. 실제로는 DAG는 빨간색이었고 서비스는 어제 데이터로 멀쩡했다. 배치 파이프라인에서 실패가 향해야 할 방향이 정확히 이것이다 — 서빙 쪽이 아니라 운영자 쪽으로.
원인은 KSPO 게이트웨이가 같은 키로 동시에 들어오는 형제 요청을 거부한다는 것이었다. 페이지를 병렬로 가져오던 수집기가 첫 페이지 이후 전부 거절당했다. 수정은 페이지 fetch를 직렬화하고 백오프 재시도를 붙이는 것이었다. 그리고 재시도 경계에서 진단 문자열을 정제한다 — data.go.kr의 fetch 에러 메시지는 serviceKey가 포함된 전체 URL을 담고 있어서, 그대로 남기면 Airflow 태스크 로그가 곧 키 유출 경로가 된다. Airflow의 자동 마스킹은 값을 알고 있는 문자열에만 작동하고 URL 안에 인코딩된 키에는 작동하지 않으므로, 정제는 에러가 만들어지는 경계에서 한다.
수정 후 도구 이미지를 다시 빌드하고 수동 run을 돌리니 6분 만에 통과했고, 다음 날 새벽 스케줄 run도 통과했다.
enrich_semantics가 9초인 이유
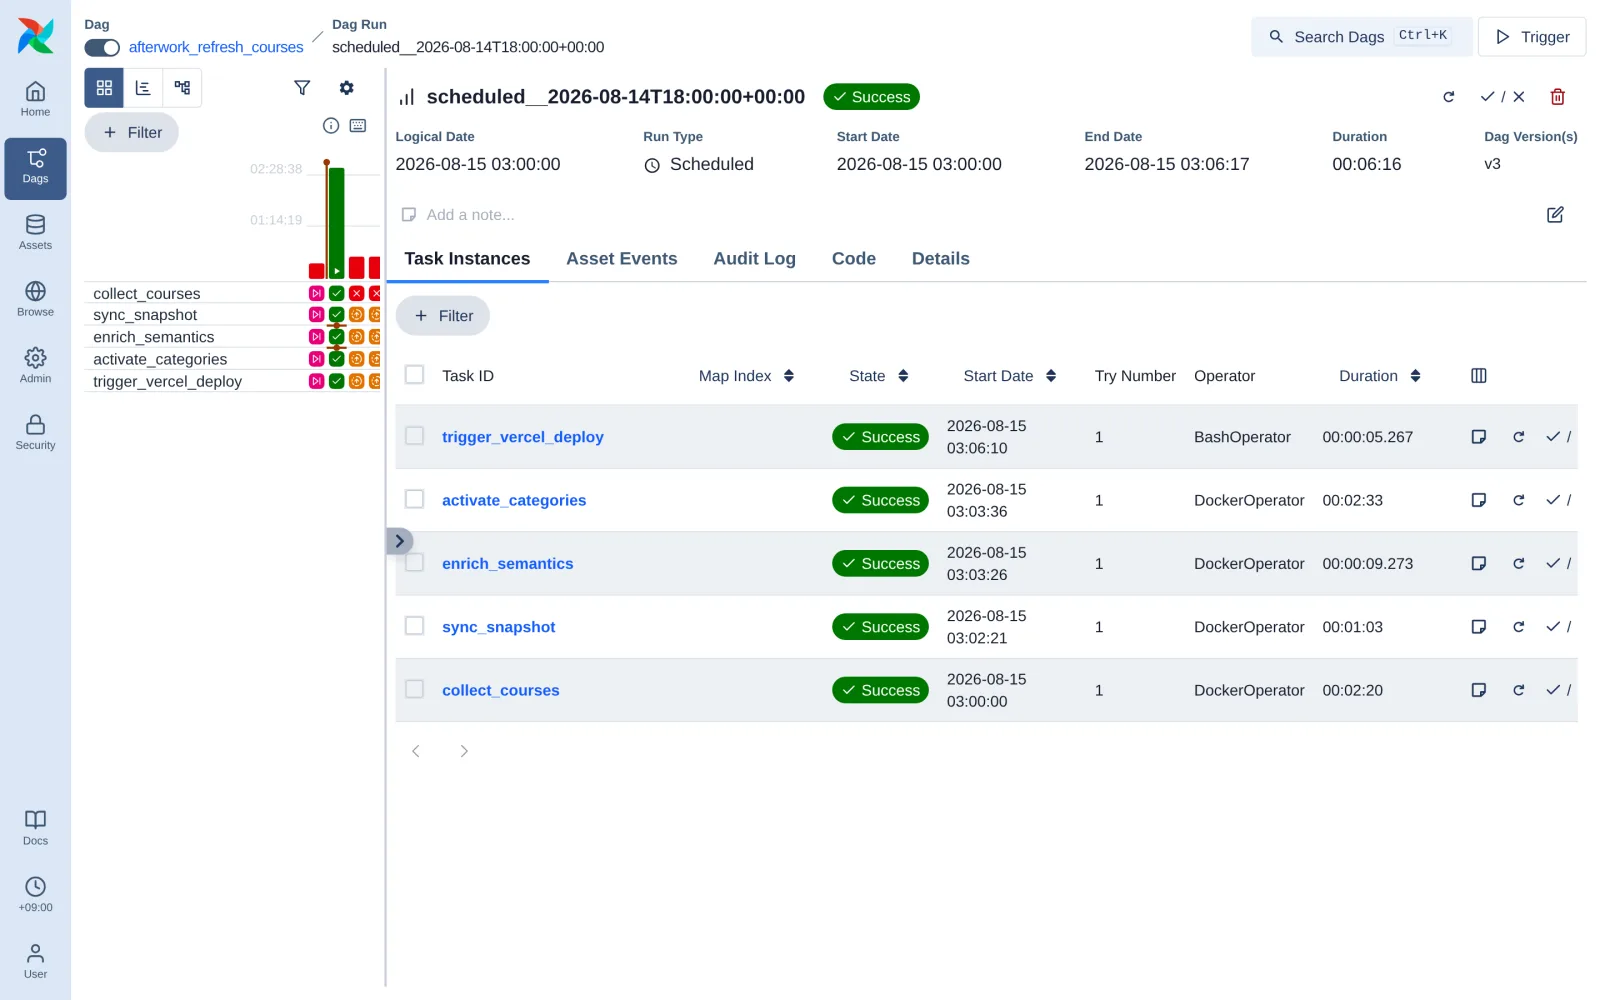
위 성공 run에서 임베딩 단계가 9초다. 2만 7천 건 코퍼스를 임베딩하는 데 9초일 리 없다 — 그리고 실제로 그러지 않았다.
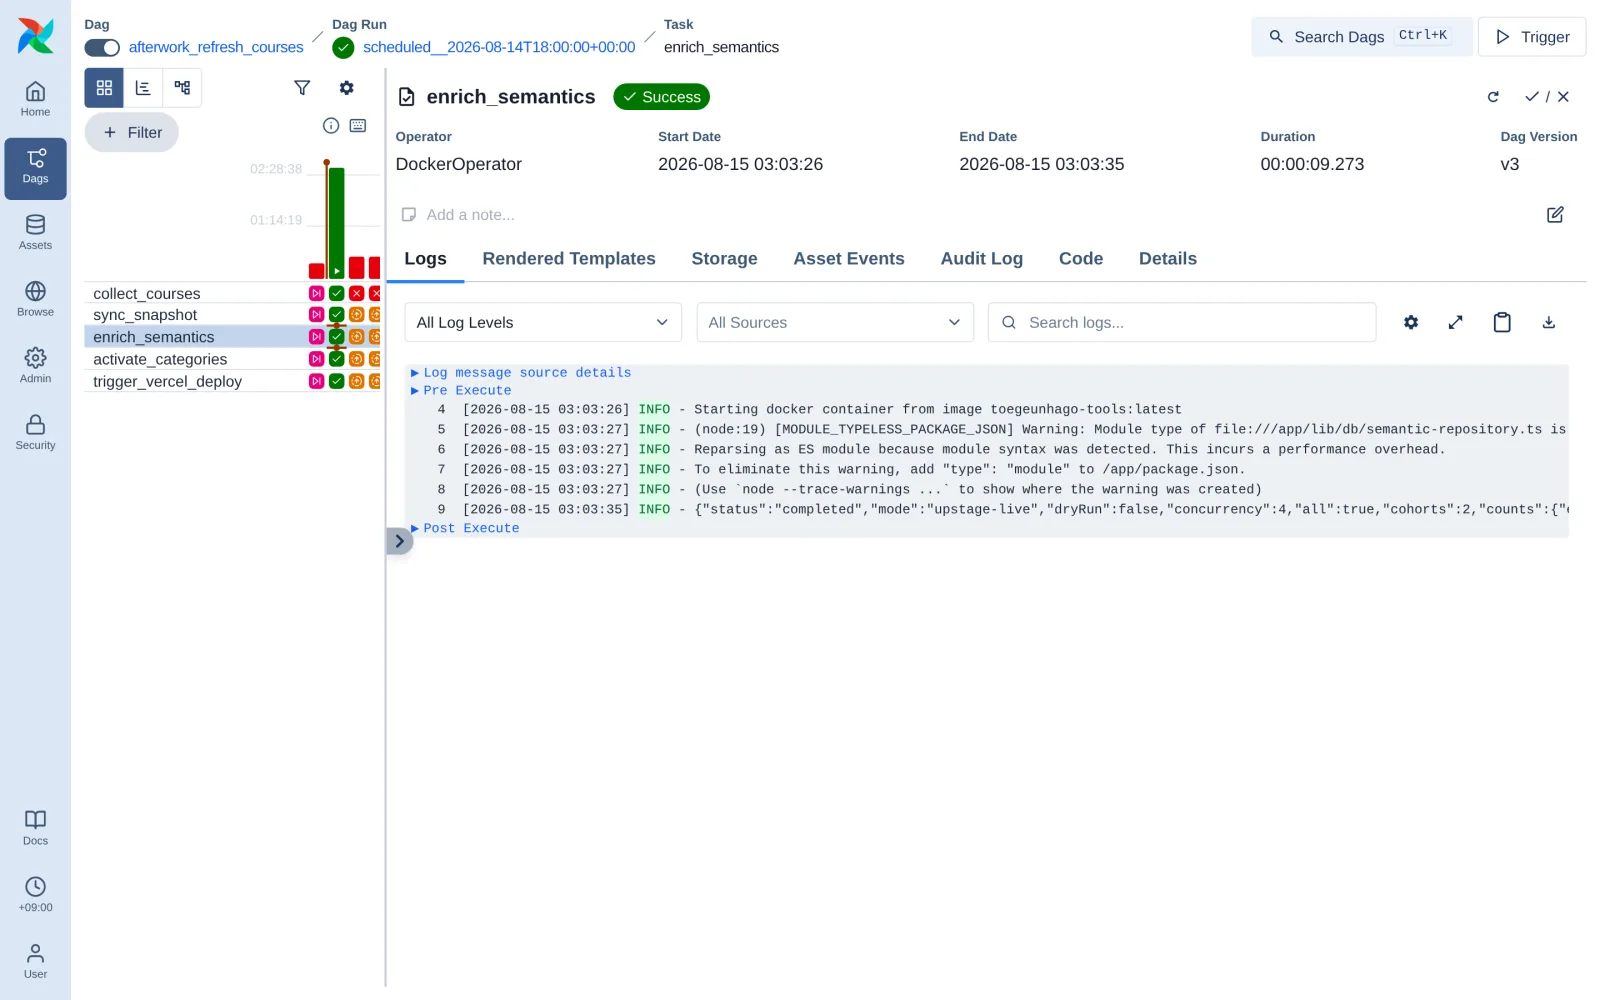
--all은 “전부 다시 임베딩”이 아니라 “전부 검사”다. 검사는 해시 비교이고, 해시가 같으면 벡터도 같으므로 건드리지 않는다. 그날 밤 실제로 텍스트가 바뀐 강좌는 21건, 그중 3건은 캐시 hit, 2건은 프라이버시 프리플라이트 차단, 남은 16건이 Upstage 호출 1번으로 처리됐다. 야간 배치의 한계 비용은 코퍼스 크기가 아니라 변경량에 비례한다. Chapter 2의 콘텐츠 주소 기반 캐시와 해시 펜스가 정확히 이걸 위해 있다.
activate_categories는 반대로 매일 밤 26,910건 전부를 다시 argmax한다(2분 33초). 코사인 26,910 × 5는 DB 안에서 싸고, 매일 전량 재계산하면 프로토타입 레지스트리가 바뀌었을 때 별도 backfill이 필요 없다.
왜 홈 서버인가, 그리고 어느 쪽이 사라져도 되는가
이 파이프라인이 도는 곳은 클라우드가 아니라 집에 있는 서버 한 대다. PoC의 호스팅 예산은 0원이고, 서빙은 Vercel + Neon 무료 티어, 배치는 홈 서버가 맡는다.
Neon 무료 티어는 저장 용량이 빡빡하다. embedding_cache 테이블은 강좌 벡터와 사실상 같은 데이터를 한 번 더 들고 있다(1024차원 float × 1만 2천 행). 그래서 캐시 DB만 홈 서버 로컬 Postgres에 두고, 강좌 테이블은 Neon에 둔다.
이게 가능한 건 캐시가 폐기 가능하기 때문이다. 홈 서버 디스크가 죽어도 모든 캐시 벡터는 Neon의 강좌 행에 있으므로 INSERT … SELECT 한 줄로, Upstage 호출 0건에 재구성된다. 데이터를 두 곳에 두는 결정은 “어느 쪽이 사라져도 되는가”에 답할 수 있을 때만 안전하다.
홈 서버의 대가는 가용성이다. 정전, ISP 장애, 내가 케이블을 잘못 뽑는 것. 그래서 GitHub Actions에 같은 다섯 단계를 workflow_dispatch 전용으로 두었다. 스케줄은 없다 — 두 오케스트레이터가 같은 밤에 같은 쿼터를 두 번 쓰면 안 되니까. 홈 서버가 죽은 날 아침에 버튼 하나 누르면 된다.
시크릿은 전부 Airflow Variables에 fernet 암호화로 저장되고, DAG 파일에는 값이 아니라 템플릿만 있다. 그리고 DAG가 SEMANTIC_EMBEDDING_PROVIDER=upstage-live를 굳이 다시 명시하는 것은 Chapter 1의 2-모드 규칙 때문이다. 키가 있어도 이 플래그가 없으면 fixture 프로바이더로 돈다. 과금되는 호출은 항상 두 곳에서 동의해야 한다.
리프레시의 마지막 단계가 배포인 이유
DAG의 마지막 태스크는 Vercel Deploy Hook에 POST 하나 보내는 것이다. Vercel 빌드 명령은 npm run export:courses && next build — 빌드 시점에 Neon에서 스냅샷을 다시 뽑아 서버리스 번들에 굽는다. 그래서 런타임 요청은 DB 라운드트립 없이 번들 안의 스냅샷을 읽고, DB가 죽어도 어젯밤 데이터로 서빙된다. Chapter 1 degradation 표의 마지막 줄이 이것이다. 데이터 리프레시가 배포를 트리거하는 구조는 “데이터가 곧 아티팩트”라는 걸 명시적으로 만든다.
매일 아침 보는 화면
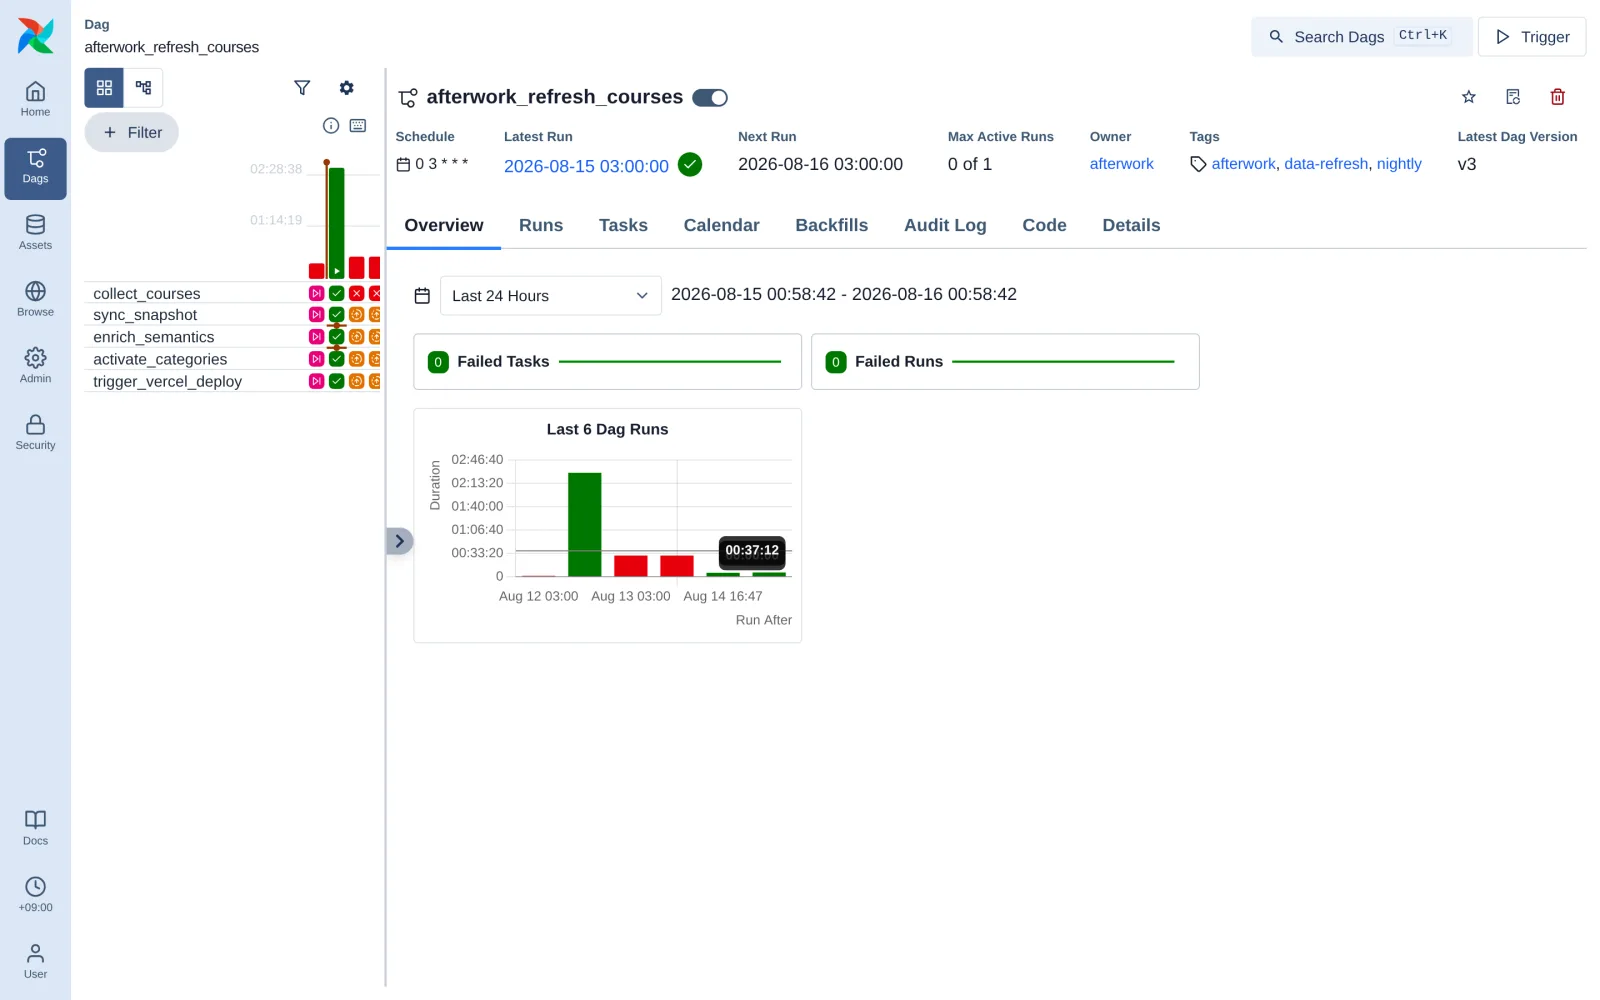
첫 수동 run의 2시간 28분은 임베딩 시간이 아니라 설치일의 배선 비용이다. Variables 이름, 캐시 DB 네트워크, 도구 이미지 태그를 하나씩 맞춰 가며 같은 run 안에서 실패한 태스크만 clear-and-rerun 한 흔적이고, 실제 태스크 실행 시간의 합은 3분이 안 된다. Airflow의 가치가 여기서도 드러난다. 앞 단계를 다시 돌리지 않고 실패한 태스크만 재개할 수 있었고, 그 과정이 전부 히스토리로 남았다.
정리
이 편에서 Airflow가 한 일은 사실 적다. 순서를 지키고, 태스크마다 다른 재시도 정책을 적용하고, 로그와 히스토리를 한 화면에 모았다. 어려운 부분은 전부 태스크 안쪽에 있었다.
- 원본 호출은 쿼터가 있는 희소 자원이다. 재시도는 그걸 아끼는 방향으로 설계한다.
- 배치 실패는 서빙이 아니라 운영자를 향해야 한다. 소스별 급감 가드는 빨간 DAG와 멀쩡한 서비스를 동시에 만든다.
- 멱등성은 오케스트레이터가 주는 게 아니라 태스크가 가져야 한다.
- 로그는 유출 경로다. 마스킹은 마지막 방어선이고, 정제는 에러가 만들어지는 경계에서 한다.
- 데이터를 두 곳에 두려면 어느 쪽이 사라져도 되는지 먼저 답한다.
이 파이프라인은 PoC를 위한 것이고, PoC의 규모에 맞다. LocalExecutor 하나, 워커 없음, 서버 한 대. 사용자가 늘고 소스가 늘면 다시 설계할 것이다. 하지만 “매일 밤 데이터가 새것이고, 실패하면 아침에 알고, 실패해도 어제 데이터로 서빙된다”는 계약은 지금 이 크기에서도 완전히 지켜지고 있고, 그게 PoC가 이 파이프라인에 요구한 전부다.